センチメント分析とは?SNSのポジネガ判定の仕組みと企業での活用例・限界
センチメント分析(感情分析・ポジネガ分析)の仕組みを、辞書方式・機械学習・大規模言語モデルの3世代で解説。SNSの投稿をポジティブ・ネガティブ・中立に分類する流れ、企業での活用例(キャンペーンの反応・炎上の兆候・競合比較)、日本語特有の誤判定と限界、ツール選定の観点を扱います。
センチメント分析(感情分析)は、文章に含まれる感情や評価を機械的に判定する技術だ。SNS運用の文脈では、自社や商品に関する投稿を**ポジティブ・ネガティブ・中立に分類する「ポジネガ判定」**として使われることが多い。
「投稿が1,000件集まった。そのうち何割が好意的か」を人手で数えるのは現実的ではない。センチメント分析は、その数え方を自動化する。ただし万能ではなく、日本語のSNS投稿には特有の誤判定がある。この記事では、仕組みと活用例に加えて、限界と付き合い方まで扱う。
センチメント分析とは
文章を入力すると、その文章が持つ評価の向きを出力する。出力の形は、ツールによって次のように分かれる。
| 出力の形 | 例 | 向いている用途 |
|---|---|---|
| 3分類 | ポジティブ/ネガティブ/中立 | 投稿の割合を見る、推移を追う |
| スコア | −1.0〜+1.0 のような連続値 | 強さの比較、閾値で抽出する |
| 感情の種類 | 喜び・怒り・悲しみ・驚き など | 反応の内訳を見る |
| 観点別 | 「価格はネガ、デザインはポジ」 | 商品のどこが評価されているかを見る |
SNS運用で最初に使うのは3分類だ。「ネガティブが増えた」「キャンペーン期間はポジティブが多かった」といった変化を捉える。
仕組み:3つの世代
センチメント分析の手法は、大きく3世代に分かれる。今のツールは2番目か3番目を使っている。
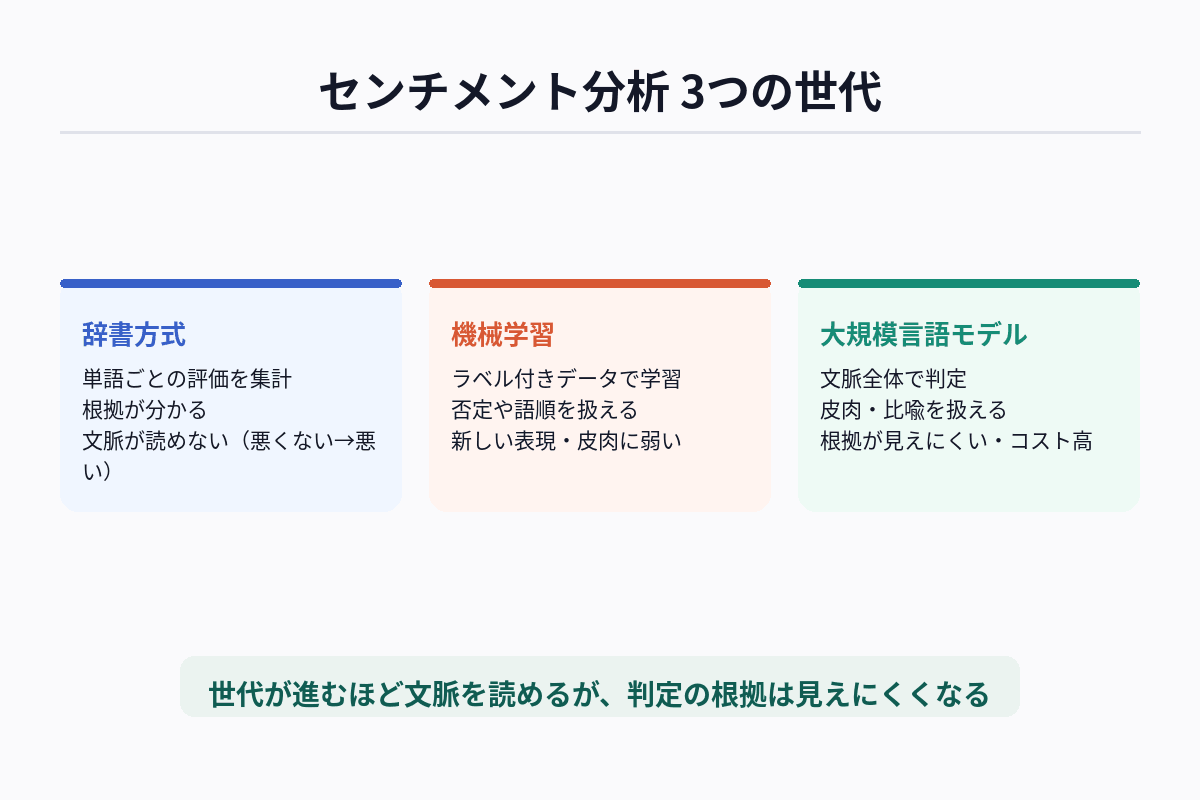 世代が進むほど文脈を読めるが、判定の根拠は見えにくくなる
1. 辞書方式
「良い」「最高」はポジティブ、「悪い」「最悪」はネガティブ、というように、単語ごとの評価を辞書に登録して集計する方式。仕組みが単純で、なぜその判定になったかが分かる。
弱点は文脈が読めないこと。「悪くない」を「悪い」と判定する、「最高に面倒」を「最高」で拾う、といった誤りが起きる。
2. 機械学習
人が「この投稿はポジティブ」「これはネガティブ」とラベルを付けた大量の文章を学習させ、新しい文章の判定を予測させる方式。否定表現や語順をある程度扱えるようになり、辞書方式より精度が上がる。
弱点は、学習データにない表現に弱いこと。新しいスラング、業界特有の言い回し、皮肉には対応しにくい。
3. 大規模言語モデル(LLM)
文章全体の意味を捉えたうえで判定する方式。皮肉、比喩、文脈依存の表現をかなりの精度で扱える。「神対応すぎて逆に怖い」のような投稿を、辞書方式は「神」でポジティブ、機械学習は判断が揺れるが、LLMは文脈で判定できる。
弱点は、判定の根拠が見えにくいこと、処理コストが高いこと、同じ文章でも判定が揺れることがあることだ。大量の投稿を毎日処理する用途では、コストとの兼ね合いになる。
SNS運用での活用例
キャンペーンや新商品の反応を見る
発売前後・キャンペーン前後で、自社名や商品名を含む投稿のポジネガ比率を比べる。件数だけでは「話題になった」ことしか分からないが、比率を見ると「良い意味で話題になったか」が分かる。
ネガティブの急増を検知する
平常時のネガティブ比率を把握しておき、そこから急に上がったら知らせる。炎上の初期には、言及数が増える前にネガティブの比率が動くことがある。監視の体制は炎上対策の体制づくり|クライシスマネジメントで整える監視・初動・役割分担で扱っている。
競合と比べる
自社と競合の商品名で同じ期間の投稿を集め、ポジネガ比率を並べる。「言及数は競合のほうが多いが、ポジティブ比率は自社が高い」といった見方ができる。
ネガティブの中身を掘る
ネガティブに分類された投稿だけを取り出し、何について不満が出ているかを読む。ここは機械で分類したあと、人が読む工程になる。件数が多いなら、観点別の分析(価格・品質・サポートなど)で内訳を出してから読む。
投稿の型を見つける
自社アカウントの過去の投稿に対する反応をポジネガで分類し、ポジティブな反応が集まった投稿の共通点を探す。次の投稿計画の材料になる。
日本語のSNS投稿で起きる誤判定
センチメント分析の結果をそのまま信じると、判断を誤る。日本語のSNSでよく起きる誤判定を知っておく。
| パターン | 例 | 何が起きるか |
|---|---|---|
| 皮肉・反語 | 「さすが〇〇、期待を裏切らない(悪い意味で)」 | ポジティブと誤判定 |
| ネガティブ語の肯定用法 | 「やばい」「えぐい」「沼」 | ネガティブと誤判定。若年層の投稿で頻発 |
| 否定の否定 | 「嫌いじゃない」「悪くはない」 | 判定が揺れる |
| 事実の報告 | 「〇〇が値上げした」 | 中立だが、値上げをネガティブと拾うことがある |
| 自社と無関係な感情 | 「〇〇を食べながら失恋した」 | 商品に対する感情ではないのにネガティブに分類 |
| 絵文字・記号だけの投稿 | 「〇〇🥹」 | 判定できないか、誤る |
対策は2つ。サンプルを人が読んで、ツールの判定がどのくらい合っているかを最初に確かめること。そして、比率の絶対値ではなく変化を見ることだ。「ポジティブ70%」という数字は誤判定を含んでいるが、「先月65%、今月55%」という変化は、誤判定の傾向が同じなら意味を持つ。
ツールを選ぶときの観点
センチメント分析は、単体のツールとしてより、ソーシャルリスニングツールの一機能として提供されていることが多い。選ぶときは次を確認する。
- 日本語への対応。 英語向けのモデルを翻訳して使っているツールは、日本語のスラングや皮肉に弱い
- 判定の根拠が見えるか。 どの語や表現で判定したかが表示されると、誤判定を見つけやすい
- 分類の粒度。 3分類だけか、スコアや観点別まで出るか
- 人が修正できるか。 誤判定を手で直し、それを学習に反映できるか
- 対応するSNS。 X・Instagram・TikTok・レビューサイトなど、見たい媒体を集められるか
Tofu Analyticsでは、収集した投稿のポジネガ判定と、判定した投稿の内訳を確認する機能を提供している。判定結果だけでなく、元の投稿にすぐ戻れることを重視した設計になっている。
ソーシャルリスニング全体の進め方はソーシャルリスニングでもっとSNSを効果的に運用しよう。ハウツーを解説、AIを使った近年の手法はAI時代のソーシャルリスニングとは?顧客インサイトを掘り起こす最新手法を解説、集めた声を施策に返す考え方はVOC(Voice of Customer)とは?分析の手順とSNSの口コミから顧客の声を集める方法を参照してほしい。
テキスト以外のセンチメント分析
SNS運用では主にテキストが対象だが、音声(コールセンターの通話の声のトーン)や表情(店頭のカメラ映像)を対象にした感情分析もある。用途はカスタマーサポートの品質管理や、店舗での体験の測定で、SNSとは別の領域になる。
導入時は、対象になる人の同意やプライバシーの扱いが、テキストの分析より厳しく問われる。SNSの公開投稿を分析する場合とは前提が違う点は押さえておきたい。
まとめ
- センチメント分析は、投稿をポジティブ・ネガティブ・中立に分類する技術。SNS運用では投稿の「割合」と「変化」を見るのに使う
- 手法は辞書方式→機械学習→大規模言語モデルと進化し、文脈を読めるようになった一方で、根拠は見えにくくなった
- 日本語のSNSでは皮肉・「やばい」の肯定用法・無関係な感情で誤判定が起きる。サンプルを人が読んで精度を確かめる
- 数字の絶対値より変化を見る。誤判定の傾向が同じなら、変化には意味がある
- ツールはソーシャルリスニングの一機能として選ぶ。日本語対応と、元の投稿に戻れることを確認する
関連する記事