Meta商用規約が10月30日に改定。事業者サイトのクロール条項とSNS運用担当の対応チェックリスト
Metaが2026年10月30日に施行する商用規約には、ビジネスアカウントに関連するサイトの巡回(クロール)条項が含まれる。条文の要点、公開後の修正、クローラー別のrobots.txt、企業の判断材料を整理する。
Metaが2026年10月30日に施行する商用規約(Commercial Terms)をめぐり、「Facebookページやインスタグラムのビジネスアカウントを持つ企業は、自社サイトの巡回(クロール)をMetaに認めたことになる」という報道が相次いだ。報道は10月15日の米Nieman Labを皮切りに広がり、日本語でもGIGAZINEなどが10月16日に取り上げている。Metaは公開後に文言を修正し、「クロールの条項は広告とビジネス向け製品に限った話だ」と説明している。
条文の細部はすでに一度書き換えられており、報道ごとに引用している文言も異なる。企業のSNS運用担当者にとって大事なのは、「どの文言が最終形か」を追いかけること以上に、施行日までに自社として何を決め、誰に確認しておくかだ。この記事では、2026年10月25日時点で公になっている情報を時系列で整理したうえで、運用担当者の判断材料とチェックリストをまとめる。
何が起きたのか:報道から修正までの流れ
まず、時系列で事実関係を並べる。
| 日付 | 出来事 |
|---|---|
| 2026年10月15日 | Nieman Labが、Metaの新しい商用規約がビジネスアカウントに関連するサイトの巡回を認める内容だと報道 |
| 10月16日 | Search Engine JournalとGIGAZINEが相次いで報道。施行日は10月30日と伝えられた |
| 10月17〜18日ごろ | Metaが規約プレビューの文言を修正。「クロール条項は広告とビジネス向け製品に限る」と説明(Social Media Today、10月18日) |
| 10月20日 | 修正後の文言では目的欄から「train(学習)」の語が消えたと報じられた(Relevant Audience) |
| 2026年10月30日 | 商用規約と、改定される「セルフサーブ広告規約」が施行 |
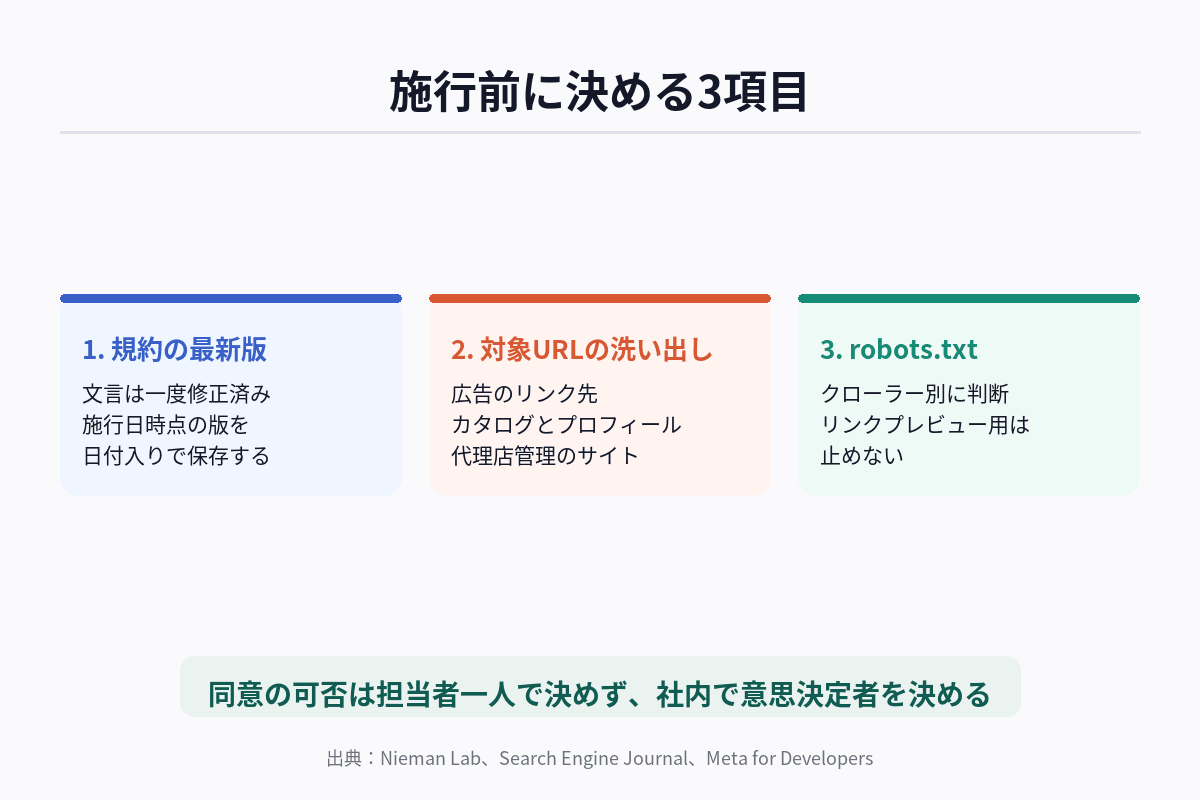 報道から施行までの流れと、施行前に決めておきたい3項目
Nieman Labの報道によれば、新しい規約はMetaが「access, index, cache, analyze, collect, retrieve, or crawl(アクセス、インデックス、キャッシュ、分析、収集、取得、巡回)」するためのソフトウェアを、ビジネスアカウントに関連するウェブサイトに対して使うことを認める内容だった。対象はFacebookページ、Messenger、Instagramのプロフィール、WhatsAppチャンネルなどを運用する事業者で、施行日以降もビジネス目的で利用を続けた時点で同意したものとみなされるという。
Metaの広報担当者は、クロールに関する記述がこれまで生成AI関連の広告規約など複数の規約に散らばっていたため、今回それを1か所にまとめたものだと説明した。そして「コンテンツの所有者は、robots.txtでアクセスの扱いを管理できる」とも述べている。
条項の中身:何を認めることになるのか
報道で共通して伝えられている要点は次の4つだ。
- 対象サイト:事業者の製品やサービスに関連づけられたドメイン、ウェブページ、URL。ユーザーがMeta製品を使うことで共有されたURLも含まれると報じられている
- 認める行為:ウェブスクレイパー、ボット、クローラーなどの自動ツールによるアクセスと収集。定期的な更新の取得も含む
- 適用範囲:広告を出稿する事業者に限らず、Facebookページの運用などビジネス目的の利用全般(Search Engine Journalの解説)
- 同意の方式:施行日以降に使い続けること自体が同意とみなされる方式
Search Engine Journalは、Meta製品でクロールを認める文言自体は、2025年8月22日付のセルフサーブ広告規約にすでにあり、そこでは「広告を出稿する(注文する)こと」に結びついていたと伝えている。今回の改定でその対象が、広告に限らない事業者全般へ広がった、というのが同誌の見立てだ。
一方、Metaは「今回の更新は、ニュースサイトのスクレイピングが目的ではない」「Metaがクローラーをどう使うかは変わらない」と説明している。修正後の文言をどう読むかは、報道機関や法律家の間でも意見が分かれている。Cornell Law Schoolのジェームズ・グリメルマン教授は、条項が学習利用の許可と読める余地があると指摘した。Loevy & Loevyの弁護士マット・トピック氏は、裁判所が執行を認めるかは不明だとしつつ、「出版社は執行可能だと想定すべきだ」と述べている(いずれもNieman Labの報道)。
修正で何が変わったのか
修正前の文言については、コンテンツを「提供、開発、改善、研究、学習(train)し、整合性を保つ」ために使えると報じられていた。修正後の文言について、Relevant Audienceは目的が「広告とビジネス向け製品の提供、開発、改善、研究、維持」に変わり、「train」の語がなくなったと伝えている。ただし同媒体は、法律面の論者が「develop(開発)」の語は学習を含みうるほど広いと読んでいることも併記している。
つまり、「学習」の語が消えたことが、学習に使われないことの保証になるかどうかは、文言だけでは断定できない。この点について、Metaが「開発」の語の範囲を個別に説明したとは報じられていない。最新の条文は、Metaの商用規約プレビューページ(facebook.com/legal/commercial_terms_preview)で、施行前にもう一度確認してほしい。
Metaのクローラーは5種類:robots.txtで何が制御できるか
規約の読み方とは別に、サイト側でできることがある。Metaは開発者向けドキュメントで、用途の異なる複数のクローラーを公開している。
| クローラー(User-agent) | 用途 | robots.txtの扱い |
|---|---|---|
| facebookexternalhit | Meta製品で共有されたサイトの内容を取得(リンクプレビューの生成) | 原則従うが、セキュリティや整合性の確認では無視することがある |
| Meta-WebIndexer | Meta AIの検索結果の品質向上 | robots.txtでの許可・拒否の例が案内されている |
| Meta-ExternalAds | 広告やビジネス向け製品の改善 | 同上 |
| Meta-ExternalAgent | 基盤AIモデルの学習、コンテンツのインデックス | 同上 |
| Meta-ExternalFetcher | ユーザーの依頼に応じて個別のリンクを取得 | robots.txtを無視することがあると明記 |
出典はMeta for Developersの「Web Crawlers」のページだ。ドキュメントには、robots.txtを更新してからクローラーに反映されるまで最大24時間かかることも書かれている。
ここで運用担当者が注意したいのは、クローラーごとに止めたときの副作用が違う点だ。たとえばfacebookexternalhitをまとめて拒否すると、FacebookやInstagramに投稿したURLのリンクプレビュー(サムネイルとタイトル)が崩れる恐れがある。広告やFacebookページの投稿で自社サイトへ誘導している企業にとっては、致命的な副作用になりかねない。止めるなら、学習用とされるMeta-ExternalAgentだけを対象にして、リンクプレビュー用のクローラーは通す、という切り分けが基本になる。
robots.txtの具体的な書き方とブロックの判断軸は、同じ構造のOpenAIの事例を扱ったGPTBotなどAIクローラーはブロックすべき? robots.txt設定の考え方を徹底解説にまとめてある。Metaのクローラー名に置き換えて読めば、設計の考え方はそのまま使える。
ただし、robots.txtには万能感を持たないほうがいい。robots.txtは従う側の自主的な遵守に依存する仕組みで、サイト側に強制力のある権利を与えるものではない。専門家の中には、商用規約への同意がrobots.txtの拒否設定より優先される、とMetaが主張する余地があると指摘する声もある(Nieman Labの報道)。robots.txtは「意思表示と技術的な歯止め」であって、規約上の同意を取り消すものではない、と整理しておくのが安全だ。
企業アカウント運用者の独自視点:影響を受けるのは「自社サイト」だけではない
この件を「Webサイト担当の話」と受け止めると、社内の確認漏れが出る。ビジネスアカウントに関連づけられるURLは、コーポレートサイトだけではないからだ。運用の現場で洗い出したい対象を挙げる。
- 広告やカタログのリンク先:キャンペーン専用のランディングページ、ECサイト、商品カタログのフィードに載るURL
- Facebookページやプロフィールに載せているURL:リンクツリー系のサービスや、外部のホスティングサービス上のページ
- 代理店や制作会社が管理するサイト:自社が名義人でも、実際のサーバー管理は外部ということがある
- 会員限定ページや事前公開ページ:報道では、テスト用の認証情報を作成してアクセスする条項があるとも伝えられている(Nieman Labは、登録の壁を越える懸念をグリメルマン教授が指摘したと報じた)
最後の点は実務への影響が大きい。未発表の商品情報や会員限定の資料を、簡易的なアクセス制限だけで置いているページがないかを、施行前に洗い出したほうがいい。簡易的な制限だけで守られていると考えるのは危うい。公開前の資料は、そもそもウェブ上に置かない運用に切り替えるのが確実だ。
代理店経由で運用している場合
複数のクライアントのFacebookページを管理する代理店は、クライアントのビジネスポートフォリオに管理者やパートナーとして入っていることが多い。クライアントが規約に同意するのか、代理店が同意するのかは、契約の構造によって変わる。誰が規約に同意する立場にあるのか、クライアントのサイトが対象になるのかは、自社で判断せず、法務または契約窓口に確認することをすすめる。
権限管理の整理については、Meta Business Suiteの使い方とログイン方法|ログインできない時の原因別対処法で、管理者を複数名に分散する運用や、退職・異動時の引き継ぎチェックを扱っている。規約の同意をめぐる確認先を明確にする意味でも、誰が管理者権限を持つかを、この機会に棚卸ししておきたい。
選択肢は3つ:使い続ける・技術的に絞る・利用をやめる
この件について、報道が伝える「選べる道」は多くない。Nieman Labによれば、10月30日より前に同意を拒否するオプトアウトの手段は用意されておらず、規約に同意しない場合の案内は「ビジネスまたは商業目的でのMeta製品の利用をすべて停止してください」とされている。そのうえで、企業は次の3つから選ぶことになる。
| 選択肢 | 内容 | 向いているケース |
|---|---|---|
| A. 使い続ける | 規約に同意したものとして運用を続ける | 広告や集客をMetaに大きく依存しており、公開サイトの内容が広く公開済みの情報にとどまる |
| B. 使い続けて技術的に絞る | 同意は前提にしつつ、robots.txtでMeta-ExternalAgentなどを個別に制御し、非公開情報をウェブ上から外す | 学習利用への懸念はあるが、広告や集客を止められない |
| C. 利用をやめる | ビジネスアカウントの利用を停止する | 機密性の高い情報をサイトで扱っており、報道機関や法務が強い懸念を示している |
現実的には、ほとんどの企業にとってCは選びにくく、AかBになる。ただし、AかBかを決める前に、その判断を誰が、いつまでに、どの記録を残して下すのかを決めておくことが大切だ。Redditが2026年9月に発表したRSS終了とAPI有料化も、AIスクレイピング対策を理由にしたプラットフォーム側の規約変更だった。Reddit、RSS配信を11月13日に終了。公開APIも有料化へ、AIスクレイピング対策の全容で整理したとおり、こうした変更は「自社が運用しているか」より「間接的に依存しているか」で影響が決まる。今回のMetaの件も同じ構図だ。
プラットフォームによるAI学習利用の扱いが利用者の反発を招いた例として、Twitch、配信コンテンツのAmazon AI学習利用がデフォルトでオンに。配信者が今すぐ確認すべきオプトアウト手順もある。Twitchの場合は設定画面でオプトアウトできたが、今回のMetaの条項は、少なくとも報道の時点では個別に外す手段が示されていない点で性格が異なる。
施行前にやること:SNS運用担当のチェックリスト
10月30日まで、2026年10月25日時点であと5日しかない。優先度の高い順に並べる。
- 規約の最新版を保存する:商用規約のプレビューページとセルフサーブ広告規約を、日付入りで保存する。文言が一度修正された以上、施行日時点の版を残しておく意味は大きい
- 意思決定者を決める:規約への同意は、広報、法務、Webの各部門にまたがる。誰が判断するのかを、運用担当者の一存にしない
- 自社に関連づけられたURLを洗い出す:広告のリンク先、カタログ、Facebookページやプロフィールに載せたURL、代理店管理のサイトまで含める
- 公開前の情報と会員限定情報の置き場所を点検する:簡易的なアクセス制限しかかけていないページは、置き場所を見直す
- robots.txtの現状を確認する:すでにMeta系のクローラーを個別に扱っているか、一括で拒否していないかを見る。リンクプレビューを担うfacebookexternalhitを拒否していないかも確認する
- 代理店や制作会社に確認する:自社名義のサイトを他社が管理している場合、robots.txtの変更権限が誰にあるのかを確認する
- 社内の問い合わせ窓口を決める:クライアントや取引先から「うちのサイトはどうなるのか」と聞かれたときの回答者を決めておく
robots.txtを変更した場合は、反映まで最大24時間かかることを見込んで、施行日の前日までに作業を終えるのが無難だ。
よくある質問
Q. 広告を出していない会社でも対象になるのか。 A. Search Engine Journalは、広告の出稿に限らず、Facebookページの運用などビジネス目的の利用全般が対象になると解説している。広告をやっていないことが、対象外になる理由にはならないと考えておくほうがよい。
Q. 規約に同意したくない場合、個別に拒否できるのか。 A. Nieman Labの報道では、10月30日より前にオプトアウトする手段は示されていない。規約の案内は、同意しない場合はビジネス目的での利用を停止するよう求めている。
Q. robots.txtでMetaのクローラーを拒否すれば、規約への同意は取り消せるのか。 A. 取り消せない。robots.txtはクローラーへの指示であって、規約上の同意とは別の仕組みだ。ただしMetaは、コンテンツの所有者がrobots.txtでアクセスを管理できると説明している。
Q. 日本の企業にも適用されるのか。 A. 地域を限定した発表ではなく、Meta製品をビジネス目的で使う事業者全般が対象として報じられている。国ごとの規約の差があるかどうかは、Metaの公式発表では明らかになっていない。施行前に、日本向けの規約ページで文言を確認してほしい。
Q. 修正後の文言なら安心してよいのか。 A. 「学習」の語が消えたことを評価する報道がある一方で、「開発」の語が学習を含みうるという読み方も報じられている。文言の解釈は固まっておらず、安心と言い切れる材料は今のところない。
まとめ
Metaの商用規約は2026年10月30日に施行され、ビジネス目的でMeta製品を使い続ける事業者は、関連サイトの巡回を含む条項に同意したものとみなされると報じられている。公開後の修正で文言は変わったが、Metaが「広告とビジネス向け製品に限る」と説明する一方、学習利用への懸念を示す専門家もおり、解釈はまだ割れている。
運用担当者がすべきことは、条文の解釈を一人で決めることではない。最新版の保存、意思決定者の指名、関連URLの洗い出し、非公開情報の置き場所の見直し、robots.txtの現状確認の5つを、施行日までに済ませておくことだ。技術的な対策としては、リンクプレビュー用のクローラーを通したまま、学習用とされるMeta-ExternalAgentだけを個別に制御する選択肢がある。規約は今後も更新されうるため、施行後も定期的に文言を確認する習慣を持っておきたい。
出典
- Meta’s new commercial terms will allow the scraping of news sites, legal experts say - Nieman Lab(2026-10-15)
- Meta’s New Terms Expand Crawling Rights Beyond Advertisers - Search Engine Journal(2026-10-16)
- Meta Updates Terms of Service Amid Concerns Around Data Scraping - Social Media Today(2026-10-18)
- Meta’s 30 Oct terms: ‘train’ removed, crawling stays - Relevant Audience(2026-10-20)
- GIGAZINE(2026-10-16)
- Web Crawlers - Meta for Developers
- Meta Commercial Terms(プレビュー)
関連する記事